Verificador de agentes de IA: devolvió cuatro de cinco
Un agente escribe código que tus tests ejecutan y frases sobre ese código que nadie revisa. Una tanda con cuatro builds devueltos, el prompt y sus límites →
Ingeniero de software · Málaga
En este artículo
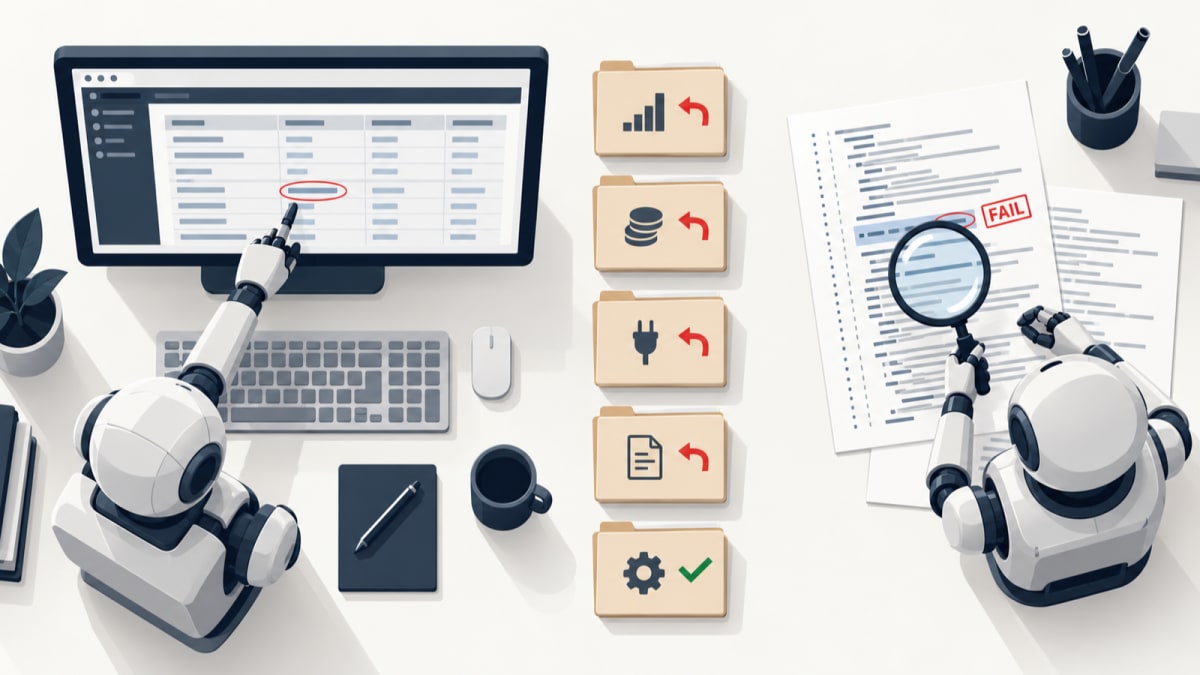
Respuesta corta: los tests de un agente comprueban su código, no lo que dice de su código, y ahí es donde acaban la mayoría de sus errores dichos con seguridad. Pon a otro agente, en un contexto limpio y con un modelo más fuerte, a buscar el código o la fuente que respalda cada afirmación, y dile que si duda, suspenda. En una tanda de cinco tareas, ese verificador devolvió cuatro builds a arreglar antes de que llegaran a la rama principal, y dejó pasar el quinto.
Lo que te entrega un agente tiene dos partes. Una es código, y tus tests lo ejecutan. La otra es todo lo que cuenta sobre ese código: el texto de la página, el README, la descripción de la PR, las cifras de una tabla, la frase de “los tests pasan”. Esa segunda parte no la ejecuta nadie. Al modelo le sale gratis y suena igual de convincente cuando está mal.
Casi todos los montajes de revisión que he visto, el mío incluido hasta hace poco, ponen al segundo agente a mirar la primera parte. Lo interesante pasa cuando le pides que mire las dos.
Seis líneas de instrucciones hacen casi todo el trabajo
Antes de contar qué pasó, el prompt, que es lo que te puedes llevar aunque no uses nada mío. Recortado a lo que importa, al verificador le digo esto:
Tu trabajo es encontrar lo que está mal, no aprobar.
Para cada afirmación sobre cómo funciona algo, busca el código o la fuente
citada que la hace verdad. Una afirmación sin respaldo es un fallo.
Recalcula al menos dos ejemplos y compáralos con el código.
Señala lo que se pidió y falta, y lo que se hizo sin que nadie lo pidiera.
Si dudas, suspende.
No quites la última línea. Sin ella, la duda acaba en “seguramente está bien”, y para eso no hace falta pagar a un segundo agente.
Cuatro de cinco builds volvieron, y dos traían tests del fallo
Esta tarde he lanzado cinco tareas independientes en paralelo en el repo de mis calculadoras. Cada una la construía un agente con Sonnet en su propio worktree de git, y la revisaba después otro agente con Opus que podía leer la rama pero no tocarla. Si el verificador encontraba algo serio, un tercer agente lo arreglaba en la misma rama.
La tarea que mejor lo explica es una página para publicar un dataset con las rentabilidades anuales del S&P 500. El texto decía que las tres columnas se copiaban del fichero original “sin recalcular”. El extractor, un script en Python que está en el repo desde septiembre, calcula una de ellas a partir del nivel del índice a final de año y divide la inflación entre 100. El verificador ha abierto el script, lo ha comparado con la página y la ha suspendido. De paso marcó un license en el JSON-LD que se leería como la licencia de unos datos que no son míos, y una entrada de BibTeX con un DOI de relleno.
Otras tres también volvieron:
- En el bloque de tipos de noviembre para la calculadora de bonos I, la inflación semestral salía 100 veces más pequeña, y la comparación a 12 meses no descontaba los tres meses de intereses que pierdes si rescatas antes de tiempo (31 CFR 359.7).
- El servidor MCP público enseñaba el tipo fijo de esos mismos bonos 100 veces más pequeño: un decimal pintado con el símbolo de porcentaje.
- Los borradores para Show HN y Medium tenían mal la hora de publicación y malinterpretaban la regla de Hacker News sobre autopromoción.
La quinta, una página de datos en español con el Euríbor y el IPC del mes, pasó sin nada serio y no necesitó arreglo.
Cada una de esas cuatro tiene su commit de arreglo en la rama, entre cinco y diez minutos después del build. Lo que me preocupa son los tests. El build de los bonos traía tests de la comparación a 12 meses y de su tipo de equilibrio, justo la zona del fallo del rescate. El del MCP traía un test de la herramienta de bonos, la del tipo mal puesto. Los dos pasaban. El agente escribió el código y los tests con la misma suposición equivocada, y claro, se daban la razón. El de los bonos es el que menos me habría gustado publicar. Un tipo de interés que se ve cien veces más pequeño en una página de ahorro es de los errores que alguien te captura y te reenvía.
Y me toca contar otra cosa. Los primeros borradores de este artículo contaron mal la tanda dos veces: una decía que tres tareas habían salido limpias y otra, que la quinta había dejado la rama vacía. Las dos veces había mirado las ramas con los agentes todavía haciendo commits y di por buena una lectura que ya no lo era. Las dos veces el revisor que puse sobre el borrador volvió a ejecutar git log y lo suspendió. Lo que estás leyendo es la versión corregida.
Un segundo modelo no prueba nada, solo filtra
La objeción es evidente: le has pedido a un modelo de lenguaje que corrija los deberes de otro. Misma familia, prompts parecidos y bastantes papeletas para que se equivoquen en lo mismo. Es así, y por eso un aprobado no lo tomo como prueba de nada.
Hay tres cosas que lo reducen, de la más barata a la más cara. Un contexto limpio, para que el verificador no vea el razonamiento que produjo el trabajo, solo el brief y la rama terminada. Un modelo distinto y más fuerte para revisar que para construir. Y convertir cada tipo de fallo que encuentra en un test determinista, para que la próxima vez lo pille sin preguntarle a nadie. El arreglo de los bonos ya hizo un poco de eso: añadió un test que comprueba el texto del bloque.
Lo que no reduce es el fallo que no ves. Sé que el verificador devolvió cuatro builds y aprobó uno. No sé si en ese, o en los arreglados, se le escapó algo, porque para medirlo habría que meter fallos conocidos a propósito y contar los que se le escapan, y no lo he hecho.
Tampoco he medido los tokens. Cada tarea cuesta como mínimo una llamada para construir y otra para verificar; esta tanda además pagó la investigación, cuatro arreglos y una revisión final del conjunto. Todo estaba en commits en un cuarto de hora desde el primer build. Es una tanda en un repo: enseña que esto pilla lo que mis tests no pillan, pero no te da una tasa con la que planificar.
Lo he publicado como dos agent skills
La tanda de arriba la hizo agency, una skill que llevaba tiempo usando en privado con Claude Code. Hoy la he limpiado y la he publicado como skeptic-agents, con licencia MIT. skeptic-build pasa una tanda de tareas por investigar, construir, verificar y arreglar; skeptic-research mira una pregunta desde varios ángulos a la vez y deja un plan con fuentes.
Al publicarla he cambiado tres cosas. La revisión de corrección y la de las normas escritas del repo van ahora por separado y salen una al lado de la otra; la idea es de la skill code-review de las skills de Matt Pocock, que son las que más uso. Cada tarea lleva un brief con criterios de aceptación y una lista de lo que queda fuera, para que el verificador tenga un contrato contra el que revisar. Y los prompts de cada rol van dentro de la skill, porque el instalador solo copia esa carpeta y mi versión privada dependía de ficheros que nunca salían de mi ordenador.
Una advertencia antes de instalarla: todo lo de este artículo se ejecutó en el modo workflow de Claude Code con la versión antigua. La skill también trae instrucciones para agentes con subagentes y sin ellos; la instalación funciona ahí, pero no he visto a ninguno de los dos sacar adelante una tanda real.
npx skills@latest add garbarok/skeptic-agentsEn Claude Code, Codex y Copilot CLI también se instala como plugin; los comandos están en el README.
Empieza por un documento que te haya escrito un agente
Coge lo último que te haya escrito un agente con afirmaciones dentro (un README, la descripción de una PR, una página con cifras) y pásaselo a una sesión nueva con las seis líneas de arriba y acceso de lectura al código. Arregla lo que no pueda respaldar. Si encuentra algo, ya tienes el argumento para meter este paso en cómo revisa tu equipo el trabajo de los agentes.
Lectura relacionada: el verificador es una de las capas del harness que rodea a un agente, y el reparto entre subagentes sale de cómo trabajo en Rydger.
Fuentes
- garbarok/skeptic-agents, versión 0.1.0, licencia MIT.
- mattpocock/skills, de cuya skill
code-reviewviene la revisión en dos ejes. - La tanda: cinco tareas del 27 de octubre de 2026 en el repo privado de mis calculadoras. Es lo que pasó en una ejecución, no una tasa de error medida.
- Penalización por rescatar antes de tiempo un bono I: 31 CFR 359.7.
P.D. Si has medido cada cuánto se le escapan fallos plantados a un revisor LLM, me interesan los números. Cuéntamelo en LinkedIn.


