Agentes de IA con muros: qué paran y qué se les cuela
OpenAI, Stripe y Spotify rodean a sus agentes de comprobaciones que no dependen del modelo. Cómo se ordenan, dónde flojea la idea y qué salió al probarla. →

Ingeniero de software · Málaga
En este artículo
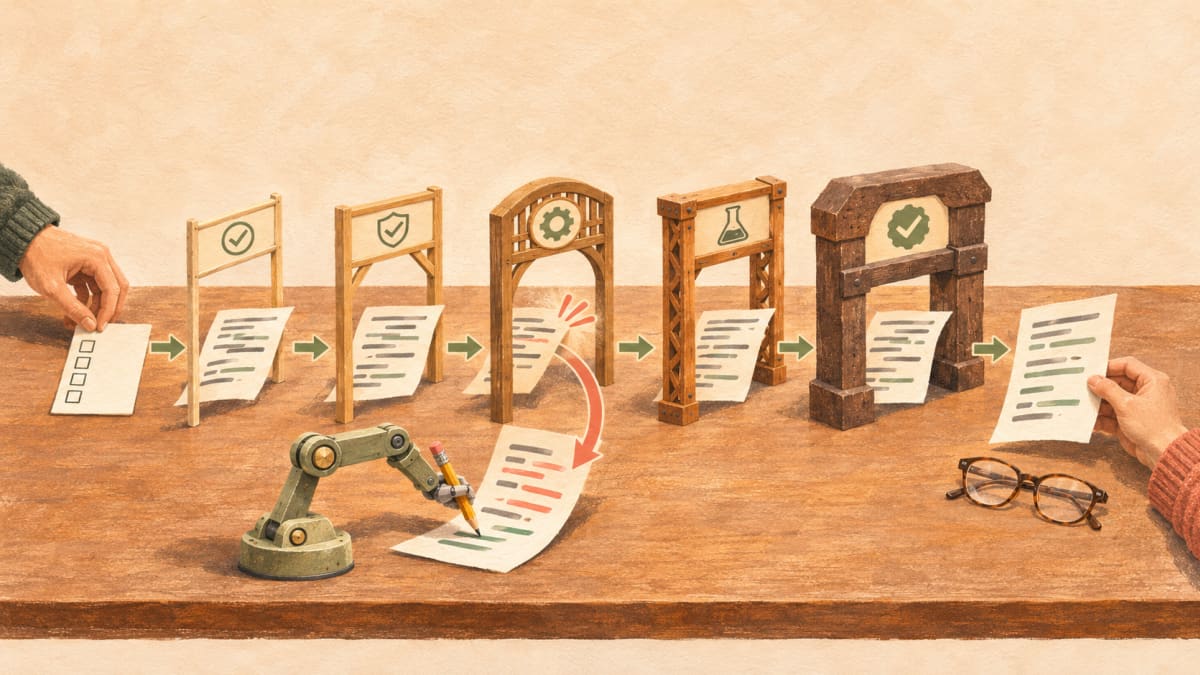
Respuesta corta: la forma de programar con agentes que describen OpenAI, Stripe y Spotify se apoya menos en el modelo que en lo que lo rodea: una cadena de comprobaciones deterministas, ordenadas de la más barata a la más cara, que o dejan pasar el trabajo o le devuelven al agente un error corto para que lo intente otra vez. La persona entra al principio, para decir qué significa “hecho”, y al final. Le pedí a un agente que la probara a escala pequeña en este blog, y lo más útil no venía en ninguno de sus artículos: en su primera pasada, los muros nuevos dieron más avisos falsos que hallazgos reales.
En febrero de 2026, OpenAI contó que un equipo suyo llevaba cinco meses construyendo la beta interna de un producto con, cito, “0 lines of manually-written code”. Esa misma semana Stripe publicó que sus agentes están detrás de más de mil pull requests fusionados cada semana, y lo describe así: “while they’re human-reviewed, they contain no human-written code”. Spotify lo había contado en diciembre: agentes que preparan cambios en segundo plano y un juez que mira cada uno antes de que se abra el PR.
Leí los tres buscando el truco, y el truco es aburrido: ninguno se fía del modelo. Lo que describen, cada uno con su vocabulario, son los muros que le ponen alrededor: linters, tests, un orden y un tope de reintentos. En lo que he leído, ninguno cuenta qué pasa el día que añades un muro nuevo. Eso lo midió un agente en mi repo, y los números están más abajo.
El agente escribe; quien decide si pasa es un script
Una instrucción en un CLAUDE.md o en una skill es un consejo. El modelo la sigue casi siempre, y ese “casi” es el problema cuando el agente trabaja solo durante horas. Un script que termina con código de salida 1 es una orden: el trabajo no avanza hasta que pasa.
OpenAI lo dice sin adornos sobre sus reglas de arquitectura: “These constraints are enforced mechanically via custom linters (Codex-generated, of course!) and structural tests.” Y su AGENTS.md dejó de ser el manual para quedarse en índice: “instead of treating AGENTS.md as the encyclopedia, we treat it as the table of contents”.
En mi propio repo hay un caso que lo ilustra. Mi skill para escribir artículos exige que cada fuente web del registro de afirmaciones lleve una cita literal y la fecha en que se leyó. Según la cuenta de un agente, en los registros de seis posts publicados hay 28 filas con fuente web: 11 no tenían cita y 11 no tenían fecha. El script contó 29; la que sobra era la URL de una imagen subida. La regla estaba escrita. Hasta el 10 de noviembre de 2026 ningún script la comprobaba.
La cadena va del muro más barato al más caro y calla cuando todo pasa
El orden importa por lo que cuesta cada paso. Un import mal puesto tiene que morir en el compilador, en segundos, y no después de diez minutos de tests de integración. Stripe pone el límite también por el otro lado: “we only have at most two rounds of CI”, porque cada ronda cuesta tokens, cómputo y tiempo.
El silencio importa por contexto. En HumanLayer calculan lo que le cuesta al agente recibir entera una pasada de tests en verde: “you just threw away 2-3% of your context window”, y todo para enterarse de que no pasaba nada. Su receta es una sola marca de OK si el paso funciona y la salida completa solo si falla.
El script que encadena los muros de este blog lee un fichero como este. Son los tres primeros muros de siete:
{
  "gates": [
    {
      "name": "lint",
      "run": "node {skill}/lint.mjs {files}",
      "hint": "every ERROR line is file:line plus the rule; rewrite the sentence, do not touch the rule"
    },
    {
      "name": "twins",
      "run": "node {skill}/checks/twins.mjs {files}",
      "hint": "the two languages must state the same numbers, sources and code"
    },
    {
      "name": "claims",
      "run": "node {skill}/checks/claims.mjs {files}",
      "hint": "every figure needs a row in the claims list; every web proof needs a verbatim quote and the date read"
    }
  ]
}
Los ejecuta en orden, para en el primero que falla y de ese imprime solo sus hallazgos. Si pasan todos, una línea, más las notas que algún muro deje para quien revisa. Según el registro del agente, sobre un post ya publicado los siete muros tardaron 8,8 segundos; sobre otro, la cadena paró en el tercero a los 0,2 segundos.
El mensaje de error es el prompt de la siguiente vuelta
Cuando quien lee el fallo es un agente, el texto del error es la instrucción con la que va a trabajar en la vuelta siguiente. OpenAI lo cuenta de sus linters: “Because the lints are custom, we write the error messages to inject remediation instructions into agent context.”
Así sale un fallo de mi cadena, recortado a un hallazgo de los 22 que dio. Cada línea dice dónde está el problema, qué falla y cómo se arregla:
GATE 3/7 "claims" FAILED in 0.2 s  (round 1 of 6)
src/content/blog/en/claude-code-skills-vs-subagents.md:71  number 1.4 has no row in .writing/claims/claude-code-skills-vs-subagents.md  -> add a row with its proof, or take the number out
claims: 22 to fix
hint: every figure needs a row in the claims list; every web proof needs a verbatim quote and the date read
El agente no puede tocar sus propios muros
Un agente al que le falla un test tiene dos caminos: arreglar el código o arreglar el test. Simon Willison lo resume al comentar el método de StrongDM: “Having the agents write tests only helps if they don’t cheat and assert true.” La respuesta de StrongDM son los escenarios, historias de usuario de extremo a extremo que, en sus palabras, están “often stored outside the codebase”. Ellos mismos los comparan con el conjunto reservado (holdout) del entrenamiento de un modelo: el agente no puede ajustar el código a un examen que no ve.
En mi cadena hay tres defensas más modestas, y las tres son código:
- Huella de los muros. Si un fichero de comprobación cambia en mitad de un bucle de arreglos, el script se niega a seguir.
- Tope de rondas. Tras seis rondas fallidas para y me dice qué muro falló el último. Reanudar es decisión mía.
- Veredicto por script. A los críticos, que son otros modelos, se les exige citar la frase que critican. Un hallazgo cuya cita no está en el fichero se descarta antes de que nadie actúe sobre él. El agente lo probó con un hallazgo inventado y el script lo descartó.
Escenarios ocultos no tengo. Mis críticos leen las mismas rúbricas que el agente que escribe, así que esa parte sigue abierta.
La persona va en los dos extremos, no solo al final
La versión de la idea que más he leído deja a la persona al final del proceso, validando lo que sale. Tiene un agujero: los muros comprueban que algo está bien construido y ninguno comprueba que sea lo que se pidió. Si el agente entendió mal el encargo, te enteras en el punto más caro.
Spotify tapa parte del agujero con el juez, que se ejecuta cuando han terminado los verificadores deterministas: “It uses the diff of the proposed change and the original prompt, and sends them to an LLM for evaluation.” Según sus métricas internas, “the judge vetoes about a quarter of them”, hablando de las sesiones de sus agentes. El juez es otro modelo, con el mismo optimismo de fábrica que el que escribe, y por eso va después de lo que no se deja convencer.
StrongDM se va al otro extremo y saca a la persona también del final: “Code must not be reviewed by humans”. Willison, que es quien lo cuenta, pregunta lo que preguntaría cualquiera: “How could that possibly be a sensible strategy when we all know how prone LLMs are to making inhuman mistakes?”
Mi apuesta es la contraria. La persona al principio, aprobando criterios de aceptación que se puedan ejecutar: un test, un comando, un escenario. Y la persona al final, leyendo lo que ha pasado todos los muros. El juez en medio no sustituye a ninguna de las dos.
La misma cadena para un microservicio Java, diseñada y sin ejecutar
Así ordenaría yo los muros de un microservicio Java. Las herramientas son las habituales del ecosistema y el orden es el del coste. No lo ha ejecutado nadie, así que antes de bloquear nada le toca la misma prueba que cuento más abajo.
| Muro | Con qué | Coste |
|---|---|---|
| Compila | javac con Maven o Gradle | segundos |
| Formato y lint | Spotless, Checkstyle | segundos |
| Tests unitarios | JUnit | segundos |
| Reglas de arquitectura | ArchUnit | segundos |
| Contrato de la API | diff contra el OpenAPI versionado | un minuto |
| Integración | Testcontainers | minutos |
| Mutación, solo sobre lo cambiado | PIT | minutos |
| Escenarios ocultos al agente | extremo a extremo, fuera del repositorio | minutos |
| Juez | un modelo con el diff y la petición | no determinista |
| Persona | revisión final | el más caro |
Dos muros de esa tabla responden a preguntas que los tests normales no contestan. El de mutación dice si los tests que escribió el agente comprueban algo o solo pasan. El de contrato impide que el servicio cambie su API sin que se entere quien la consume.
Lo que mediría desde el primer día: en cuántas vueltas pasa cada tarea, qué muro falla más y cuántas veces le llega a la persona algo que un muro debió parar.
La prueba en pequeño: tres muros nuevos sobre 26 posts publicados
Antes de los números, sus límites. El banco de pruebas es la revisión de los posts de este blog, que ya hacía un agente con un linter y cuatro críticos, y no un microservicio. Es un repo y un autor. Los muros los escribió y los ejecutó Claude en una sesión, el 10 de noviembre de 2026. Los recuentos que se podían repetir los repitieron después otros agentes que no habían visto esa sesión, todos menos los avisos de las dos reglas borradas; yo no he recontado nada a mano. Sirve para ver la mecánica, no para sacar porcentajes.
Los muros nuevos son tres. Gemelos: cada post existe en español y en inglés, escritos por separado; las cifras y las fuentes tienen que coincidir, y los dos tienen que llevar los mismos bloques de código en número y lenguaje. Registro: cada cifra del texto tiene que aparecer en el registro de afirmaciones. Citas: la frase citada está, literal, en la página que se cita.
| Muro | Sobre qué | Resultado |
|---|---|---|
| Gemelos | 26 pares publicados | 0 discrepancias |
| Gemelos | 102 commits que tocaron un post | 8 que el muro habría rechazado (gemelo ausente o cifras distintas), todos de noviembre y diciembre de 2025 |
| Registro | 189 filas en 6 registros | 10 cifras del texto que no estaban en el registro, en 2 posts |
| Citas | 17 filas con cita | 16 literales en su página |
Repetido sobre el historial, el muro de gemelos no habría parado nada en todo 2026. Y las diez cifras ausentes no son diez errores: son diez números que nadie había tenido que justificar, en posts que ya habían pasado por un crítico de exactitud. Una de ellas era el redondeo de una cifra que sí estaba.
Mis tres muros nuevos mintieron el primer día
La primera pasada fue esto:
- Una regla que buscaba cifras del registro ausentes del post dio 58 avisos según la cuenta del agente, casi todos trozos de fechas o paráfrasis. Borrada.
- Otra que comparaba el código entre idiomas dio 39, todos cadenas traducidas dentro del código. Borrada.
- “01:15” en inglés y “1:15” en español contaban como números distintos.
- La ruta de un fichero terminada en
.appse leyó como una URL. - En una fila con dos fuentes, la cita se le atribuía a la primera.
- Una fila cuya fuente era la URL de una imagen recién subida contó como fuente web sin cita. Esa no la vio el agente: la encontró el crítico de exactitud al revisar este artículo.
- A mitad de un arreglo, el agente rompió el script de registro con un reemplazo mal hecho. Lo cazó
node --checkantes de la siguiente ejecución, según su propio relato.
Con casi todo eso corregido, el muro de citas tumbó una fila del registro de este mismo artículo: una frase de Stripe que la herramienta de lectura había devuelto como literal. El borrador lo presentó como el primer acierto real del muro, y así pasó dos rondas de revisión. En la tercera, el crítico de exactitud encontró la frase: es el resumen del propio artículo y está en los metadatos de la página, que el script descarta porque solo lee el texto visible. El muro acertó al mandarme a la frase del cuerpo que cito arriba y se equivocó al dar la cita por inexistente.
De ahí sale la regla que me llevo: antes de dejar que un muro bloquee, pásalo por lo que ya sabes que está bien. Un muro que falla sobre trabajo correcto le enseña al agente a “arreglar” trabajo correcto.
La parte honesta: qué no demuestra nada de esto
Casi todo es integración continua con otro nombre. Lo que cambia es el lector del fallo: un agente que reintenta en segundos y que se cree lo que le digas.
Las tres empresas cuentan su propio éxito con sus propias métricas. En lo que he leído de ellas no he encontrado la cifra que más me interesa: cuánto se les escapa.
El muro de gemelos puede estar vigilando una puerta por la que no entra nadie; si en diez ejecuciones más sigue sin saltar, se va.
Un script comprueba la forma. El muro de citas sabe que la frase está en la página. No sabe si la página tiene razón ni si la frase sostiene lo que yo digo con ella.
Y cada muro es código que mantener. La lista de fallos del primer día es el precio de tres.
Empieza por probar una regla escrita contra tu historial
Elige una regla que hoy vive en prosa en tu AGENTS.md, del tipo “este módulo no importa de aquel”. Conviértela en un script que salga con 1 y diga cómo se arregla. Antes de ponérsela delante al agente, pásala por tus últimos cien commits. El script todavía no está en tu historial, así que el bucle lo llama por su ruta de fuera:
rule="$PWD/check-my-rule.sh"
tmp=$(mktemp -d)
for sha in $(git log --format=%h -n 100); do
  git worktree add -q "$tmp/w" "$sha" || break
  (cd "$tmp/w" && "$rule") || echo "$sha"
  git worktree remove --force "$tmp/w"
done
Empieza por reglas que solo leen el código fuente: un checkout antiguo no trae dependencias instaladas ni build. Si la regla salta en commits que sabes que estaban bien, el fallo es de la regla: arréglala o bórrala. Cuando pase limpia por lo que ya sabes que es bueno, tienes tu primer muro.
Lectura relacionada: qué es el harness y qué capas tiene lo conté en Qué es harness engineering y por qué falla tu agente. Quién lanza a los agentes y cuándo, en el post de los loops.
Fuentes
- Ryan Lopopolo, OpenAI, Harness engineering: leveraging Codex in an agent-first world, 11 de febrero de 2026.
- Alistair Gray, Stripe, Minions: Stripe’s one-shot, end-to-end coding agents, 9 de febrero de 2026.
- Max Charas y Marc Bruggmann, Spotify, Background Coding Agents: Predictable Results Through Strong Feedback Loops (Honk, Part 3), 9 de diciembre de 2025.
- Dex, HumanLayer, Context-Efficient Backpressure for Coding Agents, 9 de diciembre de 2025.
- Simon Willison, How StrongDM’s AI team build serious software without even looking at the code, 7 de febrero de 2026.
- Los números de este blog salen de scripts que un agente ejecutó el 10 de noviembre de 2026 sobre este repositorio. Cada afirmación del post tiene su fila y su prueba en un registro que guardo junto a él.
P.D. ¿Tienes un muro que te paró un desastre, o uno que tuviste que borrar porque mentía? Me interesan sobre todo los segundos. Cuéntamelo en LinkedIn.